聪明世界#19
编程中等
记性1.0M
便宜$3.8
记性换算成体感:一次能读完《哈利·波特》全七部
Gemini 系列的全模态模型 · 按发布时间
共 23 个 · 这里是相邻的 7 个 · 谷歌的全部模型 →她的房间
电脑
没有公开的编程评测成绩
书架
5 层 · 记忆 1.0M tokens
黑板
数学与科学推理
日历
知识停在 2026-03
冰箱
支持上下文缓存,能存记忆
门禁
闭源,权重不公开
身世
- 发布日期
- 2026 年 8 月 13 日models.dev
- 知识截止
- 2026-03
- 参数量
- 体型为估算值,官方从未公布参数量
- 开放权重
- 否
- 开源许可
- 暂无数据
- 上下文窗口
- 1.0M tokens
- 单次最大输出
- 66K
- 输入价格
- $0.75 / 百万 tokens
- 输出价格
- $3.75 / 百万 tokens
- 模型类型
- 全模态能听声音、也能看图,文字、图、声音一起理解
- 支持的输入
- 声音、图像、文件、文字、视频 → 文字
- 工具调用
- 是
- 深度思考
- 是
- 提示缓存
- 是
战绩
- 综合智力
- 158.0
- AIME 数学
- 97.2%
- GPQA Diamond 科学
- 94.8%
- ARC-AGI-2 抽象推理
- 84.6%
- Fiction.liveBench 长文本
- 未参评
综合智力、数学、科学、抽象推理与长文本数据来自 Epoch AI(CC-BY 4.0)。写「未参赛」的项目表示该模型没有被这项评测收录, 不代表它做不到——本站不会用估算值填补空缺。
编程战绩(按赛制分列)
- DeepSWE65.5%SWE-bench Verified 的一个变体测法,用不同的 agent 脚手架跑同一批题。第三方实测https://deepswe.datacurve.ai/
- Terminal-Bench85.8%把模型丢进一个真实终端里让它自己干完一件活——装环境、跑脚本、调错。考的是当「实习生」的本事,不只是写代码。厂商自报https://deepmind.google/models/model-cards/gemini-3-7-flash/
- FrontierCode43.6%Cognition 出的高难度代码题集,面向前沿模型。第三方实测https://cognition.com/frontiercode
- LiveBench 2.0 编程80.0%LiveBench 2.0 的编程分项:不是做题,而是接 API、写 Agent 循环、接云基础设施、做计费与限额这类真活儿。2.0 换了评测方式(长程任务、产物评审),与旧版 LiveBench 编程分不是同一把尺子,分数不可直接比较。第三方实测https://livebench.ai/?release=20261014
- ALE-Bench904AtCoder 启发式算法竞赛题,考的是给一个没有标准答案的优化问题找出尽量好的解。分数是 137–2177 的评分标度,不是百分比。和「修 bug」是两种能力。第三方实测https://epoch.ai/benchmarks
- WebDev Arena1587 Elo让两个模型各写一个网页,由人来投票选哪个更好,按对战胜负算 Elo 分。考的是前端开发的实际观感,和「能不能修复一个后端 bug」不是一回事。第三方实测https://epoch.ai/benchmarks
这些分数不可互相比较。同一个模型换一套评测脚手架就能差二三十分: SWE-bench Verified 的中位数是 75.7,而难度更高的 SWE-Bench Pro 只有 41.0。 广场上的能力条因此显示的是「在同一把尺子下排第几」,而不是分数本身。
全部成绩(按榜单分列)
名次的分母是在同一个榜、由同一类测量方测过的模型数,不是全站模型数。不同榜的分数不可互相比较。
综合
- 综合智力158.0第 19 / 225Epoch Capabilities Index,把十几项学术评测归并成一个总分。想看综合实力,先看这一栏。第三方实测https://epoch.ai/benchmarks
- LiveBench 2.0 综合68.1%第 29 / 48LiveBench 2.0 七个长程任务分类的等权均分——这个总分由本站计算,上游并不发布。第三方实测https://livebench.ai/?release=20261014
数学
- FrontierMath71.6%第 26 / 112由职业数学家出的原创难题,连数学博士都要花几小时甚至几天。分数是解出的比例,能过一成就是前沿水平。第三方实测https://epoch.ai/frontiermath
- FrontierMath 第四层36.6%第 27 / 84FrontierMath 里最难的一层,研究级别的问题,绝大多数模型接近零分。第三方实测https://epoch.ai/frontiermath
- AIME 数学97.2%第 32 / 211美国高中数学邀请赛难度的模拟题,是数学竞赛能力的通行标尺。答对比例,满分 100。第三方实测https://epoch.ai/benchmarks
- ProofBench58.0%第 21 / 96不是算出答案,而是写出完整证明并由人评判。考的是数学推理的严谨程度。第三方实测https://www.vals.ai/benchmarks/proof_bench
知识与推理
- GPQA 科学94.8%第 6 / 214博士级别的物理、化学、生物选择题,题目设计到「谷歌也搜不到答案」。随机乱猜是 25 分。第三方实测https://epoch.ai/benchmarks
- ARC-AGI-284.6%第 12 / 120看几组图形样例找规律的智力题,人类轻松、模型艰难。专门测「没见过的题会不会做」。第三方实测https://epoch.ai/benchmarks
- 带引用的研究75.5%第 23 / 48监管、法律、财税、科研五类检索与研判任务,答案要带得住核验的出处。第三方实测https://livebench.ai/?release=20261014
- ARC-AGI(第一代)95.5%第 13 / 119ARC-AGI 的第一代题库,已被第二代取代。第三方实测https://arcprize.org/
- 数据分析68.0%第 37 / 48从表格里认事件、连表、把一种格式转成另一种格式。第三方实测https://livebench.ai/?release=20261014
- SimpleQA 事实问答69.2%第 10 / 108一问一答的冷门事实题,测的是「知不知道」和「会不会瞎编」。分数低的模型更容易一本正经地胡说。第三方实测https://www.kaggle.com/benchmarks/deepmind/simpleqa-verified
- CritPt 物理14.3%第 42 / 180研究级别的物理问题,由在职物理学家出题。测的是能不能做前沿科研级的推理。第三方实测
智能体
- 长程任务29.1%第 33 / 48跑几个月的运维、财务合规、电商运营这类长线任务,看模型能不能一直把事做对。第三方实测https://livebench.ai/?release=20261014
- 浏览器操作61.2%第 28 / 48在真实网页里点选、翻页、汇总信息,考验 agent 是不是真的会用浏览器。第三方实测https://livebench.ai/?release=20261014
- APEX 专业任务67.8%第 5 / 64投行、律所、咨询公司的真实工作任务,由业内专家出题与评分。第三方实测
- 远程工作指数5.0%第 8 / 22Remote Labor Index:从自由职业平台上取的真实外包项目,看模型能独立交付多少。分数普遍很低,说明离「替代远程工作者」还远。第三方实测
游戏与谜题
- 国际象棋残局66.0%第 5 / 107给一个棋局找出最佳着法。分数是解对的比例,随机乱走约 5 分。第三方实测https://epoch.ai/benchmarks/chess-puzzles
- 推理谜题87.8%第 23 / 48心理理论、斑马谜题、空间推理这类不靠背题的死磕题。第三方实测https://livebench.ai/?release=20261014
- 推理游戏谜题37.0%第 20 / 104Epoch 自建的一组推理小游戏,测的是在规则未知的环境里摸索规律。第三方实测https://epoch.ai/benchmarks
写作
- 文档与排版75.0%第 32 / 48产出 Word 文档、PDF、PPT 三类成品,看内容组织与版式。第三方实测https://livebench.ai/?release=20261014
其他
- Dtbench96.8%第 11 / 222Epoch AI 收录的评测,暂无中文说明。第三方实测https://conceptualreasoning.ai/dtbench
- Furniture Assembly26.7%第 31 / 40Epoch AI 收录的评测,暂无中文说明。第三方实测
- Lmca50.4%第 27 / 206Epoch AI 收录的评测,暂无中文说明。第三方实测https://conceptualreasoning.ai/lmca
B 站上的 Gemini 3.7 Flash 实测7 个视频
在 B 站搜「Gemini 3.7 Flash 测评」↗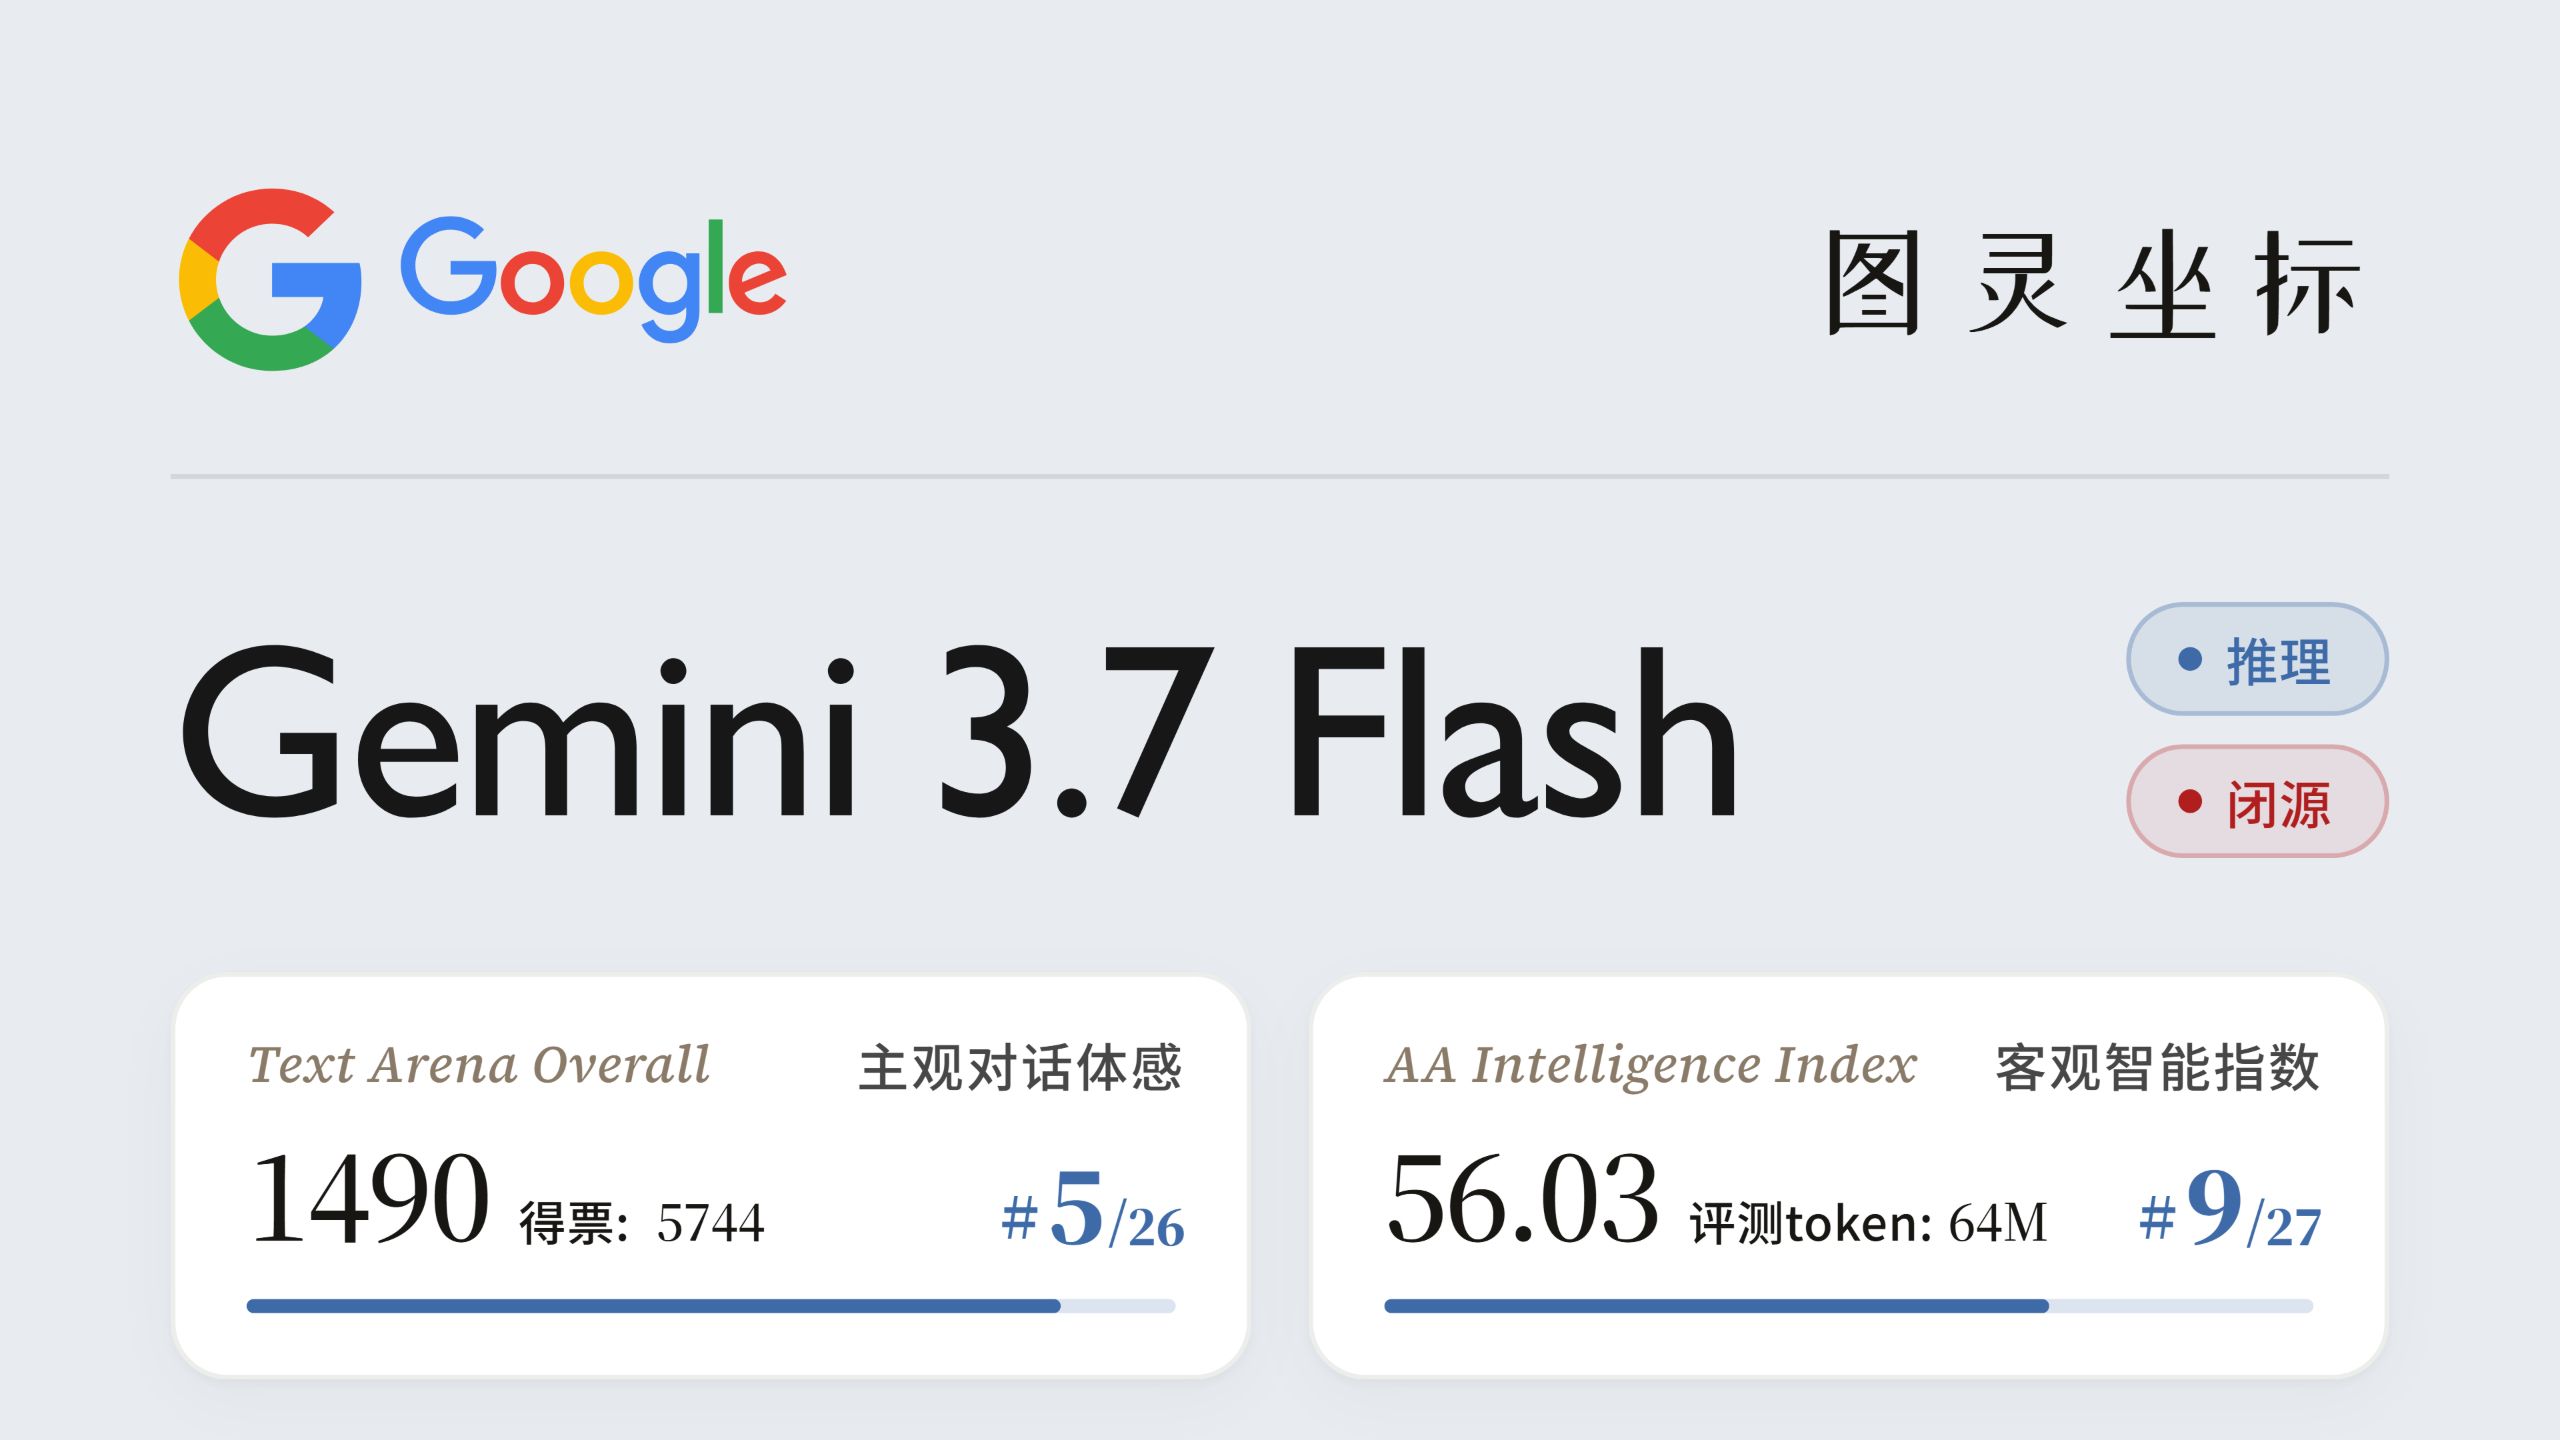 03:40Gemini 3.7 Flash 发布,其综合价格略低于 DeepSeek V4 Pro 正式版;Qwen 3.8 Max 现已开源 | 浪浪妈雷达图图灵坐标2026.08.14·12.2 万播放
 03:00Gemini 3.7 Flash:哈基米重振雄风!跑分 Terra,实测 Sol?AI 六项能力测试无机酸-_-2026.08.13·9.2 万播放
 04:40Gemini 3.7 Flash 反超 Gemini 3.1 Pro,快三倍还更便宜 ? 实测对比!进化中的阿陈2026.08.17·1.4 万播放
 02:26Gemini 3.7 Flash 测评报告!究竟有多能打?AI产品狙击手2026.08.14·7773播放
 04:22Deepseek V4 涨价后的平替方案?Gemini 3.7 Flash 深度测评与使用指南DP_IT2026.08.29·6625播放
 09:46谷歌Gemini 3.7 Flash 评测云桥网络2026.08.19·808播放
 03:42DeepSeek V4 Pro、Grok 4.6与Gemini 3.7 Flash测评,谁才是开发者的首选?敖行客Allthinker2026.08.16·457播放
以上为 B 站搜索结果,按播放量排(站长的视频置顶),内容由各 UP 主提供,不代表本站观点。